

Prosjektet ArkivOCR – Skanning for destruksjon
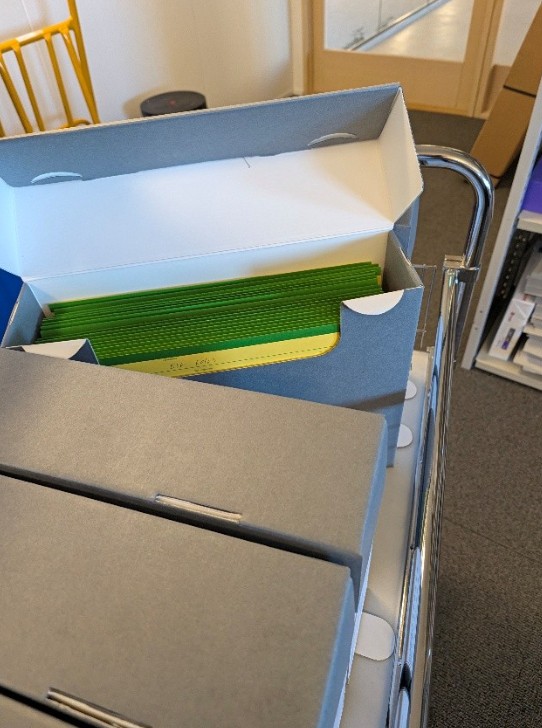
Arkivbokser fra topografisk arkiv
I høst har vi på IKA jobbet med et prosjekt for Rogalands fylkeskommune angående bruk av OCR og KI for å effektivisere arbeidet med å digitalisere et fysisk arkiv. Arkivet vi har tatt for oss for å teste dette har vært topografisk arkiv, som er et arkiv som inneholder informasjon om fysiske forhold knyttet til byggesaker. I tillegg til saksforløpet er store deler av arkivet vedlegg som ofte kommer i form av kart eller byggetegninger som viser terrengforhold, veier og lignende detaljer. Rent praktisk har formålet med prosjektet vært å klare å lage et verktøy til internt bruk som kan gjøre jobben med å koble en skannet fil til et saksnummer og deretter dele denne opp i journalposter. Vi ønsket slik å gjøre at den menneskelige involveringen i prosessen primært blir å skanne og alt annet går automatisk og på denne måten redusere tidsbruken forbundet med å digitalisere et papirarkiv.
I arkivet vi har jobbet med eksisterer det allerede et NOARK-uttrekk med skann av første side i hver journalpost. Dette har gitt oss et fint sikkerhetsnett da vi har muligheten til å la modellen sjekke mot eksisterende data. Per nå er programmet funksjonelt og på en gjennomsnittlig kjøring deles rundt 90% av journalposter opp korrekt og kobles automatisk mot riktig saksnummer. De resterende 10 prosentene er det foreslåtte saksnummer ofte korrekt, men programmet har ikke bygd seg opp nok sikkerhet til å kunne koble selv og den vil derfor sendes videre til å bli kontrollert av et menneske.
Vi har gjort flere grep for å prøve å hindre at såkalte hallusinasjoner fra KI-modellene kan oppstå og forårsake feilkoblinger. Det viktigste grepet har vært å sette så klare rammer for hvordan modellen skal jobbe som mulig. Med en gang noe havner utenfor rammene blir arkivaren varslet. I enkelte deler av arkivet ble en utskrift av tilhørende journalposter brukt som omslag for å skille mellom ulike saker. Da disse oversiktene fungerer som en oversikt over hva som skal være i saken, ble de et effektivt verktøy for å definere hva modellen skal lete etter. Vi har derfor skrevet ut tilsvarende omslag for resten av sakene basert på informasjonen tilgjengelig i NOARK-uttrekket.
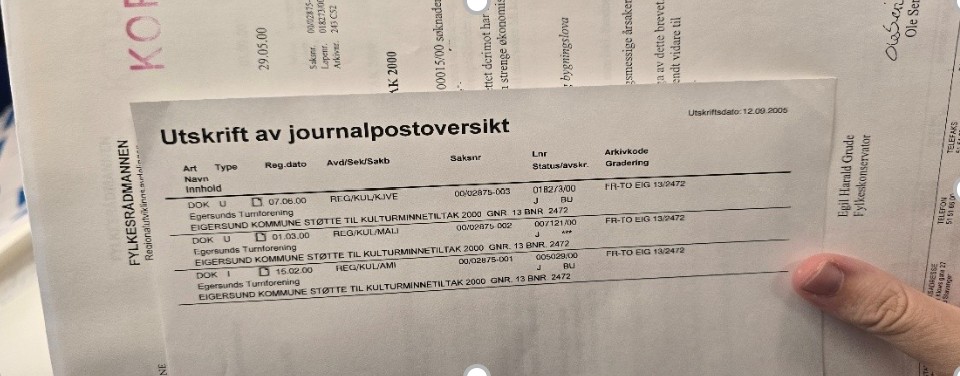
Omslag og oversikt
Et annet viktig aspekt når det kommer til rammer har vært hvordan vi definerer terskelen for at modellen kan regne seg sikker på koblingen. Modellen starter nå med en poengsum på 0 og hver bit av data som den finner (f.eks. matchende saksnummer mellom OCR og NOARK-uttrekk) gir en definert mengde poeng. Om den har nok poeng til slutt og ingen varsellamper lyser får den lov til å gjøre koblingen. Ved å gjøre det på denne måten må KI-modellen bygge seg til sikkerhet og alle de individuelle sjekkene den skal gjøre er enkle. Da dette prosjekt har vært en test på om dette kan fungere har vi naturligvis etterprøvd arbeidet en god del, både gjennom stikkprøver og grundigere gjennomgang. Vi ser at der KI-en er sikker stemmer det at den skal være sikker, der den er usikker er det vanligvis noe som er gjort på en uvanlig eller uklar måte og til slutt at det som burde tvinge fram en manuell sjekk faktisk gjør det.
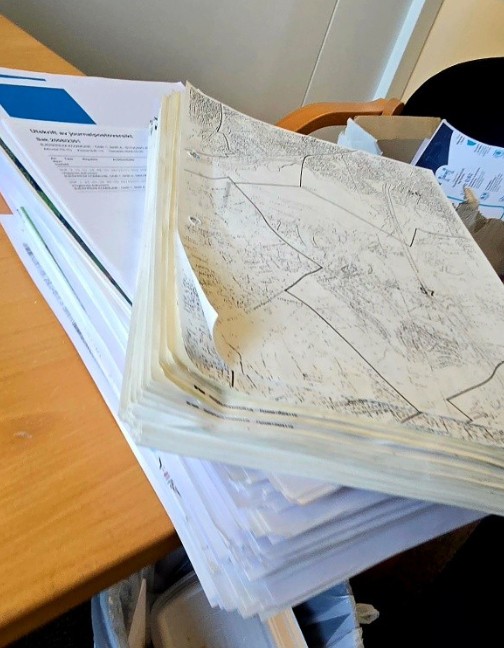
Klargjort skannebunke
Da arkiv selvfølgelig ofte kan inneholde sensitive data har det vært viktig for oss å sette opp dette systemet på en slik måte at intet skann som går gjennom programmet kan ende opp utenfor vårt nettverk. For å oppnå dette bruker vi kun KI-modeller som kan kjøre lokalt på våre datamaskiner for både OCR og selve koblingen.
Ettersom programmet finjusteres og KI-modellene forbedres vil denne prosessen kunne optimaliseres ytterligere, men når det kommer til den selve skannejobben er vi selvfølgelig fortsatt bundet opp mot den fysiske realiteten. Skanning av materialet tar tid og avhengig av graden av klargjøring (fjerning av binders o.l.) er den endelige tiden varierende. Programmet har en effekt på tiden da mindre tid brukes på å gå gjennom enkelt ark for å få oversikt. En av de større tidssperrene i arkivet vi har jobbet med har vært antallet A3-ark og større formater som naturlig nok er i et topografisk arkiv. Disses eksistens gjør at det er nødvendig å bruke en del tid på gjennomgang som ikke vil være nødvendig dersom det som skal skannes er kun A4.
Dette er enda et prosjekt underveis, men på dette stadiet føler vi at har klart å oppnå det målet vi originalt satte ut for. Den totale prosessen med skanning av sortert er effektivisert gjennom bruk av verktøyene vi har utviklet. På nåværende teknologinivå er enda ikke KI-modellene blitt gode nok til å gjøre hele jobben selv, men dette vil sannsynligvis bli mer realistisk ettersom nyere og kraftigere modeller utvikles.